ChatGPT for Academic Researchers: GPT-5.6 Sol Pro cho giới học thuật
ChatGPT for Academic Researchers đưa GPT-5.6 Sol Pro và Codex đến nhà khoa học. Cách xây quy trình nghiên cứu an toàn, tái lập được và giám sát được.
ChatGPT for Academic Researchers đưa các mô hình frontier và Codex đến gần hơn với giới nghiên cứu, nhưng code, các bước biến đổi dữ liệu, lời gọi công cụ và kết luận khoa học do AI tạo ra vẫn phải tái lập và audit được. Đơn vị cần quản lý trong production không phải một phiên chat, mà là một chuỗi có quản lý phiên bản, đi từ câu hỏi nghiên cứu đến dữ liệu, code, công cụ, đánh giá, bằng chứng, review và sản phẩm đầu ra.
OpenAI ra mắt chương trình dành cho 100,000 giảng viên và nghiên cứu viên sau tiến sĩ, bắt đầu với khoảng 10,000 người vào mùa hè này và mở rộng đến 2027. Chương trình gồm ChatGPT, ChatGPT Work, Codex cùng GPT-5.6 Sol Pro cho những người được chọn. Chương trình thay đổi khả năng tiếp cận công cụ, nhưng không loại bỏ phần việc kỹ thuật cần thiết để kết quả trở nên đáng tin cậy.
Điểm chính
- OpenAI mở quyền truy cập mô hình frontier, ChatGPT Work và Codex cho nhóm 100,000 nhà nghiên cứu.
- GPT-5.6 Sol sở hữu kết quả FrontierMath; Sol Pro sở hữu kết quả GeneBench Pro. Đây là hai benchmark khác nhau, không thể gộp thành một bảng xếp hạng.
- Codex chỉ trở thành hạ tầng nghiên cứu khi code, dữ liệu, môi trường, prompt, đầu ra công cụ và quyết định review được quản lý phiên bản cùng nhau.
- Agent harness cần có ngân sách, phân quyền công cụ, trace đầy đủ, điều kiện dừng, cổng đánh giá và cơ chế khôi phục khi lỗi.
- Agent thừa hưởng chất lượng, độ mới, lineage và giới hạn truy cập của pipeline và retrieval index mà nó đọc.
ChatGPT for Academic Researchers bao gồm những gì
Thông tin đã công bố: Chương trình cung cấp cho các nhà nghiên cứu đủ điều kiện tại những trường đại học nghiên cứu được chọn quyền truy cập miễn phí vào các sản phẩm nghiên cứu và mô hình frontier của OpenAI. Axios cho biết người được chọn có thể mời tối đa bốn cộng sự; OpenAI cho biết dữ liệu trong workspace mặc định không được dùng để huấn luyện và trọng số mô hình không được cung cấp.
| Phiên bản mô hình | Định vị của OpenAI | Cách dùng thực tế |
|---|---|---|
| GPT-5.6 Terra | Cân bằng năng lực và hiệu quả | Nghiên cứu hằng ngày |
| GPT-5.6 Luna | Phản hồi nhanh cho tác vụ nhẹ | Công việc đơn giản, ưu tiên tốc độ |
| GPT-5.6 Sol | Khoa học và toán học khó nhất | Suy luận nâng cao, phân tích khó |
| GPT-5.6 Sol Pro | Bản nghiên cứu cao cấp nhất của chương trình | Nhà nghiên cứu được chọn, quy trình đòi hỏi cao |
OpenAI công bố Sol đạt 83% FrontierMath Tier 4, so với 72.5% của GPT-5.5. SiliconANGLE đưa tin Sol Pro giải 31.5% GeneBench Pro. Hai kết quả này đến từ hai bài đánh giá khác nhau. Chương trình là một phần trong cam kết hơn $250 triệu đến năm 2027 của OpenAI.
Codex giúp nghiên cứu thực thi được, nhưng không tự động tái lập được
Codex có thể viết và debug code, phân tích dataset và xây dựng quy trình có thể tái lập. Nhưng một lần agent chạy thành công chưa phải là nghiên cứu tái lập được. Muốn bảo vệ được kết luận, nhóm cần lưu lại câu hỏi nghiên cứu đã duyệt, snapshot dữ liệu bất biến kèm hash, revision của repository, lockfile và container digest, random seed, phiên bản prompt và mô hình, trace công cụ, các sản phẩm đầu ra, test, kết quả đánh giá và quyết định của người review.
Notebook vẫn phù hợp cho giai đoạn khám phá. Nhưng trước khi một kết quả có AI hỗ trợ được dùng làm căn cứ cho kết luận khoa học, các cell liên quan phải được chuyển thành script hoặc pipeline có quản lý phiên bản, với input, output, test và hướng dẫn chạy lại rõ ràng.
Kiến trúc nghiên cứu tái lập bao quanh từng hành động của agent

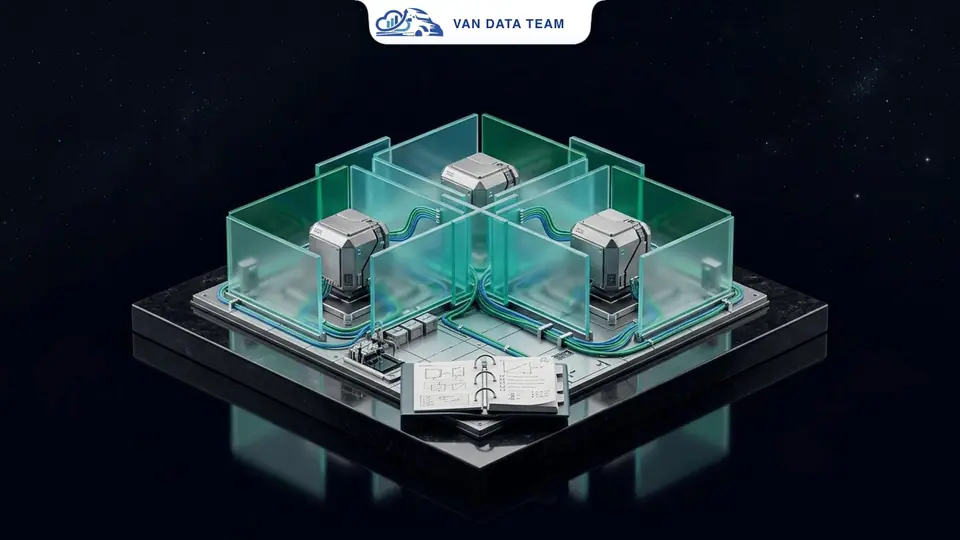
Hình 1. Kết quả tái lập được cần có input được kiểm soát, hành động của agent bị ràng buộc, bằng chứng thực thi được lưu giữ và sự phê duyệt của con người.
Mô hình đóng vai trò lập kế hoạch và viết code trong một pipeline có quản lý phiên bản, không phải là nguồn dữ liệu gốc (system of record). Đặc tả nghiên cứu xác định câu hỏi, bằng chứng, công cụ, giới hạn phương pháp, cách đánh giá và các điều kiện cần con người quyết định. Tool gateway kiểm tra từng yêu cầu, chạy code trong môi trường cô lập và chặn các truy cập mạng, dữ liệu hoặc quyền ghi chưa được duyệt. Bản đồ kết luận và bằng chứng gắn từng kết luận với nguồn, bước biến đổi, test, giới hạn và kết quả review.
Agent harness kiểm soát chi phí, công cụ, trace và khôi phục
| Thành phần harness | Kiểm soát cần có | Bằng chứng |
|---|---|---|
| Ngân sách | Token, lời gọi công cụ, retry và thời gian | Chi phí mỗi lần chạy và số lần vượt ngưỡng |
| Tool gateway | Allowlist, kiểm tra tham số, sandbox | Request, response, log |
| Checkpoint | Chạy tiếp từ bước đã thành công | State và hash của đầu ra |
| Trace | Tuyến mô hình, prompt, dữ liệu, code, công cụ | Run manifest liên kết được |
| Khôi phục | Dừng, dự phòng, rollback và chuyển cấp | Hồ sơ sự cố, người phụ trách |
Agent chỉ nên thấy các snapshot dữ liệu đã được duyệt. Khi dataset thay đổi, phải tạo một nhánh lineage mới; khi một bất biến (invariant) bị vi phạm, lần chạy phải dừng lại trước khi các bản tóm tắt phía sau được tạo lại.
Đánh giá, review của con người và nền tảng dữ liệu quyết định trần chất lượng
Đánh giá tính đúng đắn của code bằng unit test, integration test, kiểm tra schema, kiểm tra hợp lý về số liệu và các bất biến khoa học. Đánh giá tính đúng đắn của nghiên cứu bằng tác vụ chuyên ngành, grounding, kiểm chứng phương pháp và bộ kiểm thử hồi quy. Khả năng tái lập cần được chứng minh bằng việc chạy lại trong môi trường sạch từ manifest. Chất lượng kết luận cần bản đồ bằng chứng, kiểm tra trích dẫn, rà soát mức độ bất định và nêu rõ giới hạn.
Cổng duyệt của con người nên đặt trước các công cụ cần quyền cao, các thay đổi phương pháp, các bước biến đổi dữ liệu quan trọng và trước khi công bố. Bài AI agent có con người kiểm duyệt hướng dẫn cách đặt cổng duyệt mà không biến mọi hành động ít rủi ro thành một cuộc họp. Observability cho pipeline dữ liệu cần ghi lại phiên bản index, trạng thái làm mới, truy vấn, tài liệu được trả về và quyết định cấp quyền truy cập.
Checklist cho quy trình nghiên cứu agentic có thể tái lập
| Giai đoạn | Kiểm soát bắt buộc | Bằng chứng | Điều kiện để con người dừng lại |
|---|---|---|---|
| Đặc tả | Câu hỏi, phạm vi, giả định, nguồn, tiêu chí thành công có quản lý phiên bản | Đặc tả đã duyệt | Phạm vi hoặc phương pháp thay đổi đáng kể |
| Tiếp nhận dữ liệu | Snapshot, schema, nguồn gốc, lineage, độ mới | Manifest, hash, timestamp | Dữ liệu cũ, thiếu, không được phép dùng hoặc không hợp lệ |
| Môi trường | Khóa phiên bản thư viện, cấu hình, container, seed | Build manifest, lockfile | Không tái tạo được môi trường |
| Agent lập kế hoạch | Phiên bản prompt, tuyến mô hình, allowlist công cụ, chính sách dừng | Trace kế hoạch, chính sách | Công cụ hoặc phương pháp chưa được duyệt |
| Thực thi công cụ | Sandbox, kiểm tra tham số, retry có giới hạn | Request, response, đầu ra | Vi phạm quy định về dữ liệu hoặc chính sách |
| Phân tích và đánh giá | Code có quản lý phiên bản, test, đánh giá chuyên ngành, chạy lại | Revision của repo, báo cáo đánh giá | Test, bất biến hoặc độ ổn định không đạt |
| Kết luận và công bố | Bằng chứng, giới hạn, trích dẫn, phê duyệt | Quyết định của người review, đầu ra | Kết luận thiếu bằng chứng hoặc chưa được duyệt |
Một dashboard audit tối thiểu cần có run ID, phiên bản đặc tả, tuyến mô hình, prompt và chính sách, ID dữ liệu hoặc index, hoạt động gọi công cụ, token, chi phí, độ trễ, revision của code, kết quả đánh giá, nguồn gốc dữ liệu, người review và hash của đầu ra. Với dữ liệu nghiên cứu ở quy mô lớn, bộ dữ liệu bài nghiên cứu SSRN là một ví dụ tham khảo: 239.037 bài báo được thu thập qua lớp chống bot và liên kết với tác giả và trích dẫn.
Van Data Team triển khai thực tế như thế nào
Chúng tôi lập bản đồ các bước chuyển giao từ câu hỏi nghiên cứu đến kết luận đã được review: nguồn, người phụ trách, quyết định, cổng kiểm soát, dashboard, trạng thái lỗi và cách khôi phục. Chúng tôi cố định phiên bản môi trường, thư viện, dataset, snapshot retrieval, prompt, seed và cấu hình mô hình; ghi lại nguồn gốc, trace, token, chi phí và đầu ra; dùng MCP hoặc một giao diện có kiểm soát để cấp quyền công cụ trong phạm vi hẹp; và đặt cổng duyệt cho code, phương pháp và kết luận bằng bộ đánh giá kết hợp review chuyên môn.
Ngân sách vận hành
Được truy cập miễn phí không có nghĩa chi phí vận hành một quy trình tái lập được bằng không. Hãy so sánh các phương án trên cùng snapshot dữ liệu, môi trường, seed và cổng phê duyệt, theo các tiêu chí: chi phí cho mỗi đầu ra được chấp nhận, gồm mô hình, công cụ, hạ tầng, người review và khôi phục; độ trễ, giới hạn token và lời gọi công cụ; số lần retry, lỗi và chạy tiếp; số phút review; tỷ lệ đạt về tính đúng đắn, khả năng tái lập, nguồn gốc và an toàn. Chỉ số tốt nhất là chi phí cho mỗi đầu ra được duyệt, không phải giá token đơn lẻ.
Kết luận cho các đội kỹ thuật nghiên cứu
ChatGPT for Academic Researchers mở ra quyền dùng các mô hình và Codex, nhưng benchmark không thay thế được việc kiểm chứng ở cấp độ quy trình. Hãy xác định ranh giới của kết luận, cố định phiên bản input và môi trường, giới hạn công cụ, đặt điều kiện dừng, đo token, chi phí, độ trễ, độ mới của dữ liệu và quyết định của người review. Liên hệ Van Data Team để xác định phạm vi một quy trình research agent có thể tái lập, kèm sổ đăng ký rủi ro, thiết kế trace, kế hoạch đánh giá và phạm vi triển khai.

Nhà sáng lập Van Data Team, trực tiếp xây dựng Vanaxity và điều hành kỹ thuật dữ liệu, AI Agent cho các đội ngũ doanh nghiệp.
Về tác giảSo sánh mô hình AI
Các mô hình trong bài viết
Giá, cửa sổ ngữ cảnh và điểm benchmark độc lập hiện tại của từng mô hình (trang tiếng Anh).
Câu hỏi thường gặp
Những câu hỏi người đọc thường đặt ra tiếp theo.
Các câu trả lời ngắn này làm rõ những câu hỏi thực tế thường xuất hiện sau khi đọc bài viết.
Bạn cần một hệ thống tương tự?
Nếu bài viết này phản ánh một quy trình đội ngũ bạn đang vận hành, bước tiếp theo thường là rà soát có phạm vi về hệ thống, ràng buộc và lộ trình triển khai.
Buổi xác định phạm vi miễn phí
Xây quy trình nghiên cứu với ChatGPT có thể tái lập
Rà soát quy trình dùng ChatGPT for Academic Researchers để có một luồng audit được, kiểm soát được chi phí, từ code do agent tạo ra đến kết luận đã được review.
- Bản đồ quy trình gồm môi trường, phiên bản dữ liệu, seed, lineage và bước chuyển từ notebook sang pipeline
- Agent harness cho ngân sách token, giới hạn lời gọi công cụ, retry và trace thực thi
- Kế hoạch đánh giá cho code, biến đổi dữ liệu, retrieval và kết luận khoa học
- Cổng review của con người với người phụ trách, bằng chứng và tiêu chí phát hành
- Các bước tiếp theo cho pipeline, retrieval index và observability
Tư vấn
Xác định phạm vi cho quy trình AI tiếp theo.
Chia sẻ hệ thống và điểm nghẽn. Chúng tôi sẽ cùng làm rõ mức độ phù hợp, khoảng trống và bước tiếp theo.