GPT-5.6 trên Amazon Bedrock: đội phát triển agent nên làm gì tiếp theo
GPT-5.6 Sol, Terra và Luna trên Amazon Bedrock: mô hình nào hợp với từng bước agent, cache breakpoint giảm 90% chi phí ra sao, và điều gì quyết định chi phí.
Theo AWS Weekly Roundup ngày 20 tháng 7 năm 2026, GPT-5.6 trên Amazon Bedrock đã phát hành chính thức (GA) với ba cấp Sol, Terra và Luna thông qua Responses API. Trong một mục riêng, AWS đã công bố prompt thiết lập agent cho Lambda dạng copy-paste để cấu hình các coding agent được hỗ trợ với các skill AWS Serverless và Serverless MCP server. Bản tổng hợp cũng cho thấy MCP, A2A, UTCP, AG-UI và x402 hoạt động cùng nhau, với Strands Agents SDK là ví dụ triển khai.
Với các đội kỹ thuật, platform và MLOps, bài toán không chỉ là có quyền truy cập mô hình. Bài toán là quyết định mô hình nào xử lý tác vụ nào, ngữ cảnh lặp lại nên đặt ở đâu, agent được gọi những tool nào và ở bước nào con người phải phê duyệt thay đổi. Tại Van Data Team, chúng tôi bắt đầu bằng việc lập bản đồ các quyết định vận hành đó trước khi chọn stack. Đó là cách chúng tôi biến các thông báo sản phẩm thành workflow AI agent cho production với phân quyền, đánh giá, cổng review, telemetry và đường khôi phục rõ ràng.
Điểm chính
Bản tổng hợp của AWS đặt ra ba quyết định vận hành riêng biệt: quản trị mô hình, thiết lập coding agent và khả năng di chuyển của giao diện.
- Sol, Terra và Luna là những lựa chọn riêng biệt trên Bedrock, không phải lý do để dùng một mô hình duy nhất cho mọi bước của agent.
- AWS định vị Sol cho khả năng suy luận hàng đầu, Terra cho hiệu năng cân bằng và Luna cho inference nhanh, tiết kiệm chi phí.
- Cache breakpoint tường minh có thể giúp ngữ cảnh lặp lại được giảm 90% chi phí, nhưng tổng chi phí của workflow vẫn phụ thuộc vào hành vi của agent.
- Công cụ hỗ trợ thiết lập Lambda thực chất là một prompt cấu hình skill và MCP server. Nó không phê duyệt, triển khai hay gia cố bảo mật cho hệ thống production.
- Giao thức mở chỉ giảm được sự phụ thuộc vào framework khi các đội quản trị tốt schema, phân quyền, phiên bản, lỗi và dữ liệu audit.
AWS thực sự đã công bố những gì
AWS đưa tin về ba cập nhật riêng biệt (mô hình, thiết lập và khả năng tương tác) trong cùng một bản tổng hợp hàng tuần; AWS không công bố một sản phẩm agent trọn gói nào.
| Mục trong bản tổng hợp | Thông tin AWS công bố | Giới hạn khi dùng cho production |
|---|---|---|
Mô hình khả dụng trên Bedrock | Sol, Terra và Luna đã GA thông qua Responses API | Có quyền truy cập mô hình không có nghĩa là đã có định tuyến, đánh giá, fallback hay escalation cho con người |
Thiết lập coding agent cho Lambda | Prompt dạng copy-paste cấu hình các skill AWS Serverless và Serverless MCP server | Prompt chỉ là khung sườn khởi đầu, không phải pipeline production tự động |
Demo giao thức mở | MCP, A2A, UTCP, AG-UI và x402 hoạt động cùng nhau trong ví dụ dùng Strands Agents SDK | Strands chỉ là SDK minh họa; các mẫu này không bị giới hạn trong một framework duy nhất |
AWS mô tả Sol là cấp suy luận hàng đầu, Terra là lựa chọn cân bằng và Luna là lựa chọn nhanh, tiết kiệm chi phí. AWS cũng cho biết giá tương đương giá bán trực tiếp của OpenAI và mức sử dụng được tính vào các cam kết chi tiêu với AWS. Đây là thông tin về mua sắm và quyền truy cập. Chúng không cho đội platform biết cấp nào sẽ đáp ứng được mục tiêu về chất lượng, độ trễ hay chi phí vận hành của riêng họ.
Mục về Lambda thuộc một luồng phát triển khác. Lập trình viên sao chép prompt từ Lambda console hoặc lấy từ tài liệu AWS, rồi dán vào một coding agent được hỗ trợ. AWS tóm tắt mục đích rất rõ:
Cách diễn đạt đó rất quan trọng. Prompt cung cấp cho coding agent hướng dẫn về AWS Serverless và kết nối Serverless MCP server. Nó không chứng minh được rằng hạ tầng được sinh ra tuân thủ nguyên tắc đặc quyền tối thiểu, rằng cơ chế retry phù hợp với workload, hay rằng thay đổi được đề xuất đủ an toàn để merge.
Phần demo giao thức lại là một chuyện riêng. AWS dùng Strands Agents SDK để minh họa các giao thức kể trên chạy cùng nhau và cho biết các mẫu này áp dụng cho mọi agent framework. Tín hiệu thực tế là khả năng kết hợp linh hoạt, không phải yêu cầu bắt buộc dùng Strands.
Vì sao GPT-5.6 trên Amazon Bedrock quan trọng với agent có quản trị
Hình minh họa sau tóm tắt nguyên tắc: nhiều lớp tách biệt, một cổng kiểm soát thay đổi:

Hình 1. Các năng lực do AWS công bố nằm ở những lớp riêng, trong khi đội platform vẫn chịu trách nhiệm về định tuyến, phân quyền, đánh giá, phê duyệt và bằng chứng cần có trước khi chấp nhận một thay đổi serverless được đề xuất.
GPT-5.6 trên Amazon Bedrock mang lại cho các đội lấy AWS làm trung tâm thêm một kênh truy cập mô hình có quản trị, trong khi prompt Lambda (một mục riêng) có thể chuẩn hóa cách coding agent bắt đầu làm việc với serverless.
Lợi ích rõ nhất khi doanh nghiệp vốn đã quản lý việc dùng mô hình, danh tính cloud, chi tiêu và bằng chứng vận hành thông qua AWS. Bedrock có thể trở thành ranh giới truy cập mô hình cho các cấp GPT-5.6 này. Prompt thiết lập Lambda vẫn là cơ chế cấu hình coding agent nằm ngoài Bedrock. Giữ rõ sự phân biệt đó giúp sơ đồ kiến trúc, trách nhiệm sở hữu và các cơ chế kiểm soát không bị gộp thành một "AWS agent stack" mơ hồ.
Kiến trúc vận hành nên tách truy cập mô hình trên Bedrock, cấu hình coding agent, MCP và quyền dùng tool, code serverless, cùng review và telemetry thành các lớp có người sở hữu riêng.
Biến các cấp mô hình thành chính sách định tuyến
Nhãn phân cấp của AWS là đầu vào hữu ích, nhưng định tuyến trong production phải dựa trên các bài đánh giá mang tính đại diện.
| Cấp ứng viên | Định vị của AWS | Đề xuất của Van Data Team |
|---|---|---|
| Sol | Suy luận hàng đầu | Đánh giá cho các kế hoạch phức tạp, hướng khắc phục chưa rõ ràng và các quyết định có rủi ro cao |
| Terra | Hiệu năng cân bằng | Dùng làm baseline đánh giá chung khi cả chất lượng lẫn chi phí vận hành đều quan trọng |
| Luna | Inference nhanh, tiết kiệm chi phí | Đánh giá cho các bước đơn giản, lặp lại thường xuyên hoặc nhạy cảm với độ trễ |
Cột cuối là phân tích của Van Data Team, không phải khuyến nghị chính thức của AWS. Đội ngũ nên chạy thử mọi ứng viên trên cùng một bộ tác vụ và ghi lại tỷ lệ hoàn thành tác vụ, đầu ra thiếu căn cứ, tính hợp lệ của đối số khi gọi tool, độ trễ, lượng token tiêu thụ, số lần retry, tần suất escalation và hành vi khôi phục. Giá và độ trễ là dữ liệu cần đo, không phải giả định cố định.
Một chính sách định tuyến thực tế sẽ trả lời những câu hỏi sau:
- Agent đang xử lý loại tác vụ nào?
- Cấp nào là ứng viên mặc định cho loại tác vụ đó?
- Dấu hiệu nào sẽ kích hoạt fallback hoặc escalation?
- Những hành động nào luôn cần con người phê duyệt, bất kể đầu ra của mô hình là gì?
- Đội sẽ phát hiện bằng cách nào khi workload thay đổi khiến chính sách không còn phù hợp?
Hãy xét một đội platform giả định đang xây một công cụ nội bộ chạy trên Lambda. Đội có thể đánh giá Sol cho việc phân tích các lỗi khó xác định, Terra làm baseline cho công việc triển khai thông thường và Luna cho các bước lặp lại đơn giản hơn. Đội không chọn route nào chỉ vì nhãn của nó nghe hợp lý. Một route chỉ được đưa vào dùng sau khi tất cả ứng viên đã chạy qua cùng một harness đánh giá.
Xem prompt caching là một chính sách kinh tế
Prompt caching phát huy tác dụng khi agent liên tục nhận cùng một ngữ cảnh ổn định, chứ không chỉ đơn giản vì prompt dài. Những phần phù hợp để cache có thể gồm system instruction, chính sách dùng tool, schema đã được duyệt, quy ước của repository, ràng buộc bảo mật và rubric đánh giá. Dữ liệu riêng của từng request, trạng thái triển khai thay đổi liên tục, credential tạm thời và input của người dùng thuộc phần động.
Cache breakpoint nên được đặt theo ranh giới trách nhiệm sở hữu. Khi một chính sách thay đổi, đội cần biết đoạn cache nào đã lỗi thời, những lần chạy nào đã dùng nó và phiên bản mới đã được xác minh ra sao. Telemetry về cache nên được đặt cạnh dữ liệu về mô hình, tác vụ, ngân sách token, retry, tool call và kết quả, để mức tiết kiệm được đánh giá ở cấp workflow.
Sai lầm chúng tôi thường gặp là coi mức chiết khấu trong tài liệu như dự báo chi phí cho toàn bộ một lần chạy của agent. Lợi ích của cache có thể bị pha loãng bởi ngữ cảnh động quá nhiều, retry lặp lại, tool call không cần thiết hoặc việc đẩy mọi tác vụ sang cấp mạnh nhất. Những đội đã tìm hiểu về tối ưu chi phí AWS cho workload dữ liệu nên áp dụng cùng kỷ luật đó ở đây: gắn chi phí với workflow, không chỉ với tên dịch vụ hay tên mô hình.
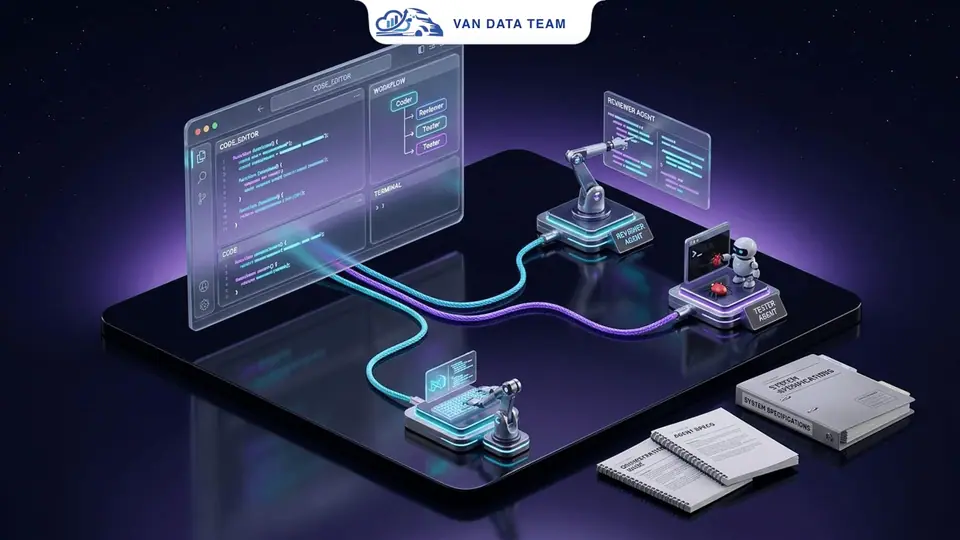
Cách áp dụng prompt thiết lập Lambda một cách an toàn
Quy trình an toàn là tải bản prompt hiện tại của AWS về, đọc kỹ, dán vào coding agent đã chọn và review mọi thay đổi cấu hình hoặc code được tạo ra trước khi merge.
AWS có tài liệu hướng dẫn thiết lập cho Claude Code, Kiro, Cursor, GitHub Copilot, Codex, Devin Desktop và OpenCode. Đoạn PowerShell sau tải file Markdown được cung cấp và chép nội dung vào clipboard:
$setupPromptUrl = "https://docs.aws.amazon.com/lambda/latest/dg/samples/aws-lambda-agent-setup.md"

Invoke-WebRequest -Uri $setupPromptUrl -OutFile ".\aws-lambda-agent-setup.md"

Get-Content -Raw ".\aws-lambda-agent-setup.md" | Set-Clipboard
Lệnh này chỉ tải về và sao chép prompt. Nó không tạo tài nguyên Lambda, không triển khai hạ tầng và cũng không tạo ra một hệ thống agent sẵn sàng cho production.
Trước khi dán, hãy đọc aws-lambda-agent-setup.md để nắm hướng dẫn hiện tại và những thay đổi dự kiến. Sau khi agent xử lý xong, hãy review:
- Các skill, file cấu hình, lệnh và dependency được thêm hoặc thay đổi
- Lệnh, đối số, biến môi trường và phạm vi truy cập của Serverless MCP server
- Quyền dùng tool và quyền IAM trên AWS so với workflow thực tế
- Code ứng dụng hoặc hạ tầng được sinh ra, kể cả các giả định về môi trường
- Logging, xử lý lỗi, retry, hành vi timeout và ảnh hưởng tới rollback
- Test, kiểm tra bảo mật, kế hoạch triển khai và toàn bộ diff trong hệ thống quản lý phiên bản
Đừng duyệt một quyền cloud rộng chỉ vì phần thiết lập do AWS cung cấp. Prompt có thể cấu hình agent hoàn toàn đúng, nhưng yêu cầu triển khai sau đó của agent vẫn có thể vượt phạm vi cần thiết. Nguyên tắc tương tự áp dụng cho code được sinh ra: hãy review hành vi được đề xuất chứ không chỉ cú pháp. Hướng dẫn của chúng tôi về thiết kế AI agent có vòng review của con người chỉ ra cách đặt bước phê duyệt ở những điểm có hệ quả lớn mà không bắt con người kiểm tra từng bước vô hại.
Trong một kịch bản triển khai giả định, platform lead trước tiên áp dụng prompt thiết lập trên một branch dùng tạm. Đội review các skill mới và cấu hình MCP, yêu cầu agent dựng khung một công cụ chạy trên Lambda, rồi chạy các bước kiểm tra hạ tầng, bảo mật và ứng dụng như thường lệ. Chỉ khi đó người phụ trách mới duyệt merge. Prompt giúp thiết lập nhanh hơn; quy trình kỹ thuật hiện có vẫn chịu trách nhiệm về kết quả.
Vì sao ranh giới giao thức mở quan trọng hơn việc chọn SDK
Ranh giới giao thức mở có thể giảm tình trạng bị khóa chặt vào một nền tảng agent khi logic của workflow dựa trên các contract kiểm thử được, thay vì các lời gọi đặc thù của framework nằm rải rác khắp codebase.
Ví dụ của AWS bao gồm đầy đủ các giao thức được nêu trong bản tổng hợp: MCP, A2A, UTCP, AG-UI và x402. MCP không phải toàn bộ câu chuyện về khả năng tương tác, và Strands Agents SDK cũng không phải lựa chọn triển khai duy nhất. Quyết định kiến trúc hữu ích là làm cho mỗi ranh giới giao thức trở nên tường minh và có thể thay thế.
| Mô hình tích hợp | Điểm mạnh | Hạn chế | Khi nào nên chọn hoặc thử nghiệm |
|---|---|---|---|
Tích hợp native của framework | Triển khai nhanh trong phạm vi một SDK | Logic workflow có thể bị gắn chặt với đối tượng và quy tắc vòng đời của framework | Thử nghiệm các workflow khép kín, ít có nhu cầu thay thế |
Ranh giới giao thức mở | Contract rõ ràng hơn, dễ thay thế adapter hơn | Cần quản trị phiên bản, xác thực, schema và lỗi | Ưu tiên khi các thành phần có thể phát triển độc lập với nhau |
Adapter point-to-point tự viết | Khớp chính xác cho tích hợp phạm vi hẹp | Chi phí bảo trì và rủi ro sai lệch hành vi tăng theo mỗi kết nối | Chỉ dùng cho những chỗ mà ranh giới chuẩn không đáp ứng được |
Với mỗi ranh giới, hãy ghi lại giao thức, người sở hữu interface, phiên bản schema, phương thức xác thực, các hành động được phép, chính sách timeout và retry, contract lỗi, các trường audit và test tương thích. Khi có thể, hãy giữ các quyết định nghiệp vụ như định tuyến, phê duyệt và khôi phục nằm ngoài adapter của SDK.
Observability cũng phải xuyên qua các ranh giới. Một trace cần cho phép operator nối yêu cầu của agent với việc chọn mô hình, việc dùng tool, phản hồi từ hệ thống hạ nguồn, quyết định chính sách, bước review của con người và kết quả cuối cùng. Nếu một thành phần lỗi, runbook phải nêu rõ nên retry, đổi adapter, fallback sang route khác, tạm dừng để review hay dừng an toàn.
Checklist thực tế về mức độ sẵn sàng cho production
Một workflow agent sẵn sàng cho production cần có chính sách, bằng chứng và cơ chế khôi phục rõ ràng bao quanh các năng lực của AWS, vì việc có sẵn mô hình và khung sườn được sinh tự động chỉ là đầu vào.
- Chính sách mô hình: Gán các cấp ứng viên theo loại tác vụ và chỉ định người chịu trách nhiệm cho từng quyết định định tuyến.
- Đánh giá: Kiểm thử với công việc đại diện, đối số khi gọi tool, hành vi từ chối, các kiểu lỗi, độ trễ, lượng token sử dụng và tổng chi phí vận hành.
- Fallback: Xác định khi nào retry, đổi route, yêu cầu con người review hoặc dừng mà không thực hiện hành động.
- Caching: Tách ngữ cảnh ổn định khỏi ngữ cảnh động, đánh phiên bản cho chính sách được cache và giám sát hành vi cache cùng với kết quả của workflow.
- Nguồn gốc prompt: Lưu lại phiên bản prompt thiết lập của AWS, review các thay đổi và chạy lại các bước kiểm tra khi nguồn thay đổi.
- Phân quyền: Giới hạn quyền truy cập của coding agent, MCP, cloud, repository và triển khai ở mức tối thiểu mà workflow cần.
- Observability: Liên kết prompt, route mô hình, tool call, lỗi, phê duyệt và trạng thái cuối cùng mà không làm lộ nội dung nhạy cảm.
- Contract giao thức: Viết tài liệu interface độc lập với Strands hay bất kỳ SDK nào khác và duy trì test ở cấp adapter.
- Kiểm soát phát hành: Dùng quy trình code review thông thường, review hạ tầng, kiểm tra bảo mật, triển khai theo giai đoạn và quy trình rollback.
- Trách nhiệm vận hành: Chỉ định người xử lý khi định tuyến, cache, tool hoặc dịch vụ hạ nguồn hoạt động bất thường.
Các kiểu lỗi phổ biến đều dễ đoán: dùng cấp mạnh nhất ở mọi nơi, cache ngữ cảnh có thể thay đổi, chấp nhận quyền được sinh tự động mà không review, giấu hành vi giao thức bên trong một SDK duy nhất và phát hành khi chưa kiểm thử đường dừng. Playbook vận hành AI agent trong production đề cập đến lớp giám sát, fallback và escalation cần bao quanh phần thiết lập này.
Với các đội muốn có phạm vi triển khai cụ thể thay vì thêm một slide kiến trúc, Van Data Team có thể cung cấp ma trận ánh xạ tác vụ với mô hình, bản đồ ngữ cảnh lặp lại, danh mục tool và phân quyền, bản đồ ranh giới giao thức, kế hoạch đánh giá cùng checklist rollout và rollback. Xác định phạm vi workflow mô hình và agent dựa trên các hạng mục đó.
Ngân sách vận hành
AWS cho biết GPT-5.6 trên Amazon Bedrock dùng mức giá bán trực tiếp của OpenAI, được tính vào các cam kết chi tiêu với AWS và hỗ trợ cache breakpoint tường minh giúp giảm giá cho ngữ cảnh lặp lại. Những thông tin đó xác định các lựa chọn mua sắm, nhưng không phải chi phí vận hành của một workflow agent.
Trước khi rollout, hãy chạy Sol, Terra và Luna trên cùng một bộ đánh giá đại diện. Với mỗi ứng viên, ghi lại chất lượng ở cấp tác vụ, độ trễ end-to-end, token input và output, mức dùng cache, tần suất retry, số phút review, công sức khôi phục lỗi và tỷ lệ kết quả vượt qua đánh giá cũng như được con người phê duyệt.
Dùng một chỉ số so sánh duy nhất (chi phí trên mỗi kết quả được phê duyệt):
cost per approved result = (model + tool + retry + review + recovery costs) / approved workflow results
Chỉ số này ngăn một lời gọi mô hình giá rẻ trông có vẻ tiết kiệm trong khi thực tế lại gây thêm retry, kéo dài thời gian review hoặc khiến việc khôi phục tốn kém. Nó cũng cho thấy thế mạnh suy luận của Sol, sự cân bằng của Terra hay inference tiết kiệm chi phí của Luna phù hợp nhất với bước cụ thể nào.
Van Data Team khuyến nghị đặt ngân sách riêng cho định tuyến, thực thi, kiểm tra hợp lệ và khôi phục. Hãy xem prompt caching là một cách tối ưu cho ngữ cảnh ổn định được lặp lại, rồi xác minh rằng thiết kế cache không giữ lại các chỉ dẫn đã lỗi thời. Chỉ đưa một cấp mô hình vào dùng khi kết quả đánh giá và hành vi lỗi của nó đáp ứng tiêu chí phê duyệt của workflow trong phạm vi ngân sách vận hành đã định.
Công cụ và mức độ phù hợp trong hệ sinh thái
Hãy xem bản tổng hợp của AWS như một danh sách các lớp có thể kết hợp với nhau, không phải một stack bắt buộc. AWS đưa GPT-5.6 lên Amazon Bedrock thông qua Responses API, giúp các đội lấy AWS làm trung tâm có thể dùng chung một ranh giới cho truy cập mô hình và quản trị thương mại. Định tuyến mô hình vẫn là quyết định kỹ thuật: dùng Sol cho việc nặng về suy luận, Terra khi cần cân bằng và Luna cho tác vụ cần nhanh, tiết kiệm chi phí, rồi kiểm chứng từng route bằng bộ đánh giá của chính bạn.
Orchestration là một lựa chọn riêng. AWS dùng Strands Agents SDK để demo MCP, A2A, UTCP, AG-UI và x402 cùng nhau, nhưng Strands chỉ là một phương án triển khai. Workflow agent dùng LangGraph có thể phù hợp với các đội cần chuyển trạng thái, rẽ nhánh và checkpoint tường minh; orchestrator hiện có vẫn có thể giữ nguyên nếu nó hỗ trợ các interface cần thiết.
Prompt copy-paste cho Lambda thuộc một lớp khác: khung sườn ở giai đoạn phát triển. Nó cấu hình các coding agent được hỗ trợ với skill AWS Serverless và Serverless MCP server, nhưng không thay thế được các kiểm soát lúc runtime.
Cách phân lớp vận hành thực tế là:
- Lớp mô hình: định tuyến Sol, Terra hoặc Luna theo chính sách tác vụ và chi phí; cache phần ngữ cảnh agent được lặp lại.
- Lớp giao thức: chuẩn hóa interface và schema, độc lập với SDK.
- Lớp runtime: thực thi phân quyền, observability, xử lý lỗi và các checkpoint review của con người.
- Lớp khung sườn (scaffolding): review mọi thay đổi do prompt thiết lập sinh ra trước khi triển khai.
- Lớp pipeline: áp cho code dữ liệu do agent sinh ra cùng mức cam kết về độ mới, lineage và SLA như code do con người viết.
Với các đội dữ liệu, lớp pipeline là nơi ảnh hưởng trực tiếp nhất. Chính những coding agent dùng để dựng khung các hàm serverless ngày càng sinh ra cả phần code kết nối quanh workflow dữ liệu: Airflow DAG, dbt model và luồng ingestion từ Kafka nạp dữ liệu cho chúng. Vì vậy, code do agent viết giờ đây ảnh hưởng đến chất lượng dữ liệu production chứ không chỉ logic ứng dụng. Function calling native và các mẫu Plan-and-Execute cho phép agent nối các bước đó từ đầu đến cuối, nhưng sự tự chủ đó cũng làm rủi ro tăng lên: một dbt model trông hợp lý hay một script backfill có thể âm thầm gây ra schema drift hoặc đẩy dữ liệu sai xuống hạ nguồn. Hãy đánh giá mọi thay đổi dữ liệu do agent sinh ra theo đúng các tiêu chí vận hành mà data engineering vốn đã đo (độ mới, lineage và SLA), và bắt nó đi qua cùng các bài test, data contract và bước review mà bạn yêu cầu với một pull request do con người viết. Serverless MCP server và các giao thức mở giúp việc cấp cho agent quyền truy cập có quản trị vào các hệ thống đó dễ dàng hơn; nhưng chúng không thay bạn quyết định khi nào một pipeline là đáng tin cậy.
Kết luận
GPT-5.6 trên Amazon Bedrock mở rộng lựa chọn mô hình cho các đội phát triển agent lấy AWS làm trung tâm, nhưng lợi thế bền vững đến từ chính sách vận hành bao quanh các lựa chọn đó. Định tuyến Sol, Terra và Luna theo loại tác vụ đã được đánh giá. Chỉ cache phần ngữ cảnh ổn định và có người sở hữu. Giữ prompt thiết lập Lambda ở trạng thái review được. Hãy xem MCP, A2A, UTCP, AG-UI và x402 là các ranh giới có quản trị, thay vì chỉ là nhãn trên sơ đồ kiến trúc.
Các thông báo này liên quan với nhau qua quy trình kỹ thuật, chứ không được đóng gói thành một sản phẩm duy nhất. Bedrock cung cấp kênh truy cập mô hình như AWS mô tả. Prompt Lambda cấu hình riêng phần hướng dẫn cho coding agent và MCP server. Strands là một demo riêng về cách các giao thức mở kết hợp với nhau.
Đầu ra hữu ích tiếp theo không phải là một bản proof of concept chung chung. Đó là chính sách định tuyến mô hình có phạm vi rõ ràng, bản đồ phân quyền, danh mục contract giao thức, harness đánh giá và kế hoạch khôi phục. Van Data Team có thể giúp biến phạm vi đó thành kế hoạch triển khai production với trách nhiệm rõ ràng từ khâu khảo sát đến triển khai.

Nhà sáng lập Van Data Team, trực tiếp xây dựng Vanaxity và điều hành kỹ thuật dữ liệu, AI Agent cho các đội ngũ doanh nghiệp.
Về tác giảSo sánh mô hình AI
Các mô hình trong bài viết
Giá, cửa sổ ngữ cảnh và điểm benchmark độc lập hiện tại của từng mô hình (trang tiếng Anh).
Câu hỏi thường gặp
Những câu hỏi người đọc thường đặt ra tiếp theo.
Các câu trả lời ngắn này làm rõ những câu hỏi thực tế thường xuất hiện sau khi đọc bài viết.
Bạn cần một hệ thống tương tự?
Nếu bài viết này phản ánh một quy trình đội ngũ bạn đang vận hành, bước tiếp theo thường là rà soát có phạm vi về hệ thống, ràng buộc và lộ trình triển khai.
Tư vấn
Xác định phạm vi cho quy trình AI tiếp theo.
Chia sẻ hệ thống và điểm nghẽn. Chúng tôi sẽ cùng làm rõ mức độ phù hợp, khoảng trống và bước tiếp theo.