Bảo mật Agentic AI sau Project Perception: quản trị trước khi hành động
Project Perception đưa bảo mật Agentic AI từ cảnh báo sang hành động. Runbook về cổng phê duyệt, đặc quyền tối thiểu, rollback, nhật ký kiểm toán và đánh giá.
Project Perception biến bảo mật Agentic AI thành một vấn đề vận hành, chứ không chỉ là thêm một câu chuyện về cảnh báo. Điều này quan trọng với các đội kỹ thuật, bảo mật và platform đang xây dựng hoặc phòng thủ bằng AI agent. Các cuộc tấn công ở tốc độ máy có thể vượt xa khả năng phản ứng ở tốc độ con người, trong khi những agent chỉ biết cảnh báo lại dồn mọi việc khắc phục cho các analyst vốn đã quá tải. Bài viết này đưa ra runbook quản trị và rollout cho các agent có quyền hành động: cổng phê duyệt, quyền truy cập theo phạm vi, triển khai theo giai đoạn, rollback và bằng chứng kiểm toán. Tại Van Data Team, chúng tôi hiện thực hóa sự chuyển dịch đó qua workflow AI agent cho production, trong đó quyền hạn, cổng kiểm duyệt và phương án phục hồi được xác định trước khi agent có quyền ghi.
Project Perception hiện ở giai đoạn public preview. Microsoft nêu rõ sự chuyển dịch vận hành trong thông báo ngày 27 tháng 7 năm 2026, đặt public preview vào ngày 3 tháng 8 năm 2026 và mô tả mô phỏng tấn công, điều tra mối đe dọa và khắc phục lỗ hổng:
"Đó sẽ là khả năng liên tục nhận biết, suy luận và hành động của họ."
Bài viết tách biệt các dữ kiện do Microsoft công bố với khuyến nghị vận hành của Van Data Team. Nội dung tập trung vào kiến trúc phòng thủ và quản trị, không hướng dẫn khai thác lỗ hổng.
Điểm chính cần nhớ
Bài học vận hành từ Project Perception là quyền hành động cần được kiểm soát chặt hơn quyền cảnh báo. Các cơ chế kiểm soát sau tạo thành một nền tảng thực tế.
- Project Perception kết nối lập bản đồ rủi ro, điều tra và hành động khắc phục trong một vòng lặp đa agent được điều phối.
- Mẫu có thể tái sử dụng là tách biệt việc tạo bằng chứng, đánh giá rủi ro và thực thi có kiểm soát.
- Thay đổi có tác động lớn cần phê duyệt của con người, rollout theo giai đoạn, rollback tự động, đặc quyền tối thiểu và nhật ký chống chỉnh sửa.
- Điểm benchmark cao không chứng minh được sự an toàn trên production; các đội còn cần đánh giá hồi quy, tuân thủ chính sách, phục hồi, chi phí, độ trễ và chất lượng dữ liệu.
Project Perception thay đổi bảo mật Agentic AI như thế nào
Project Perception thay đổi cách vận hành bảo mật bằng cách liên kết mô phỏng tấn công, điều tra mối đe dọa và hành động khắc phục trong một hệ thống agent được điều phối. Nó chuyển workflow từ chỗ chỉ tạo cảnh báo sang thực thi có quản trị.
Thông tin được công bố: Project Perception vượt ra ngoài cảnh báo
Microsoft mô tả Project Perception như một đội ngũ agent chuyên biệt, suy luận trên dữ liệu, công cụ và workflow bảo mật. Các agent này phát hiện lỗ hổng phòng thủ, điều tra mối đe dọa và khắc phục chúng. Nền tảng vẫn đang ở giai đoạn public preview, vì vậy các đội nên đánh giá các cơ chế kiểm soát của nó trước khi giao quyền trên production.
Theo thông báo ra mắt mô hình của Microsoft AI, MAI-Cyber-1-Flash là mô hình bảo mật đầu tiên do Microsoft tự huấn luyện. Mô hình được thiết kế để tìm các lỗ hổng khó phát hiện trong code phức tạp và chạy bên trong MDASH. Microsoft cho biết MDASH điều phối hơn 100 agent chuyên biệt trên các mô hình frontier và distilled. Harness này đã tìm ra lỗ hổng trong các codebase của Microsoft và đạt khoảng 96% trên CyberGym, cao hơn khoảng 12 điểm phần trăm so với cấu hình dựa trên Mythos.
Theo trang sản phẩm Project Perception, nền tảng bắt đầu với các agent Red, Blue và Green. Red lập bản đồ đường tấn công và lỗ hổng. Blue điều tra các phát hiện và xác định rủi ro đáng kể, còn Green viết và triển khai bản vá, đồng thời củng cố lớp phòng thủ.
Trang sản phẩm cũng cho biết các hành động có tác động lớn vẫn cần con người ký duyệt. Ranh giới này quan trọng khi hiểu chữ "tự động". Cột cuối của bảng dưới đây là mô hình kiểm soát do Van Data Team khuyến nghị, không phải tuyên bố về sản phẩm của Microsoft.
| Vai trò agent | Chức năng được công bố | Ranh giới kiểm soát khuyến nghị |
|---|---|---|
| Red | Lập bản đồ đường tấn công và lỗ hổng | Tạo bằng chứng nhưng không được phê duyệt khắc phục |
| Blue | Điều tra phát hiện, lọc nhiễu và xác định rủi ro đáng kể | Đánh giá rủi ro và áp dụng chính sách nhưng không được triển khai |
| Green | Viết và triển khai bản vá, đồng thời củng cố phòng thủ | Thực thi trong phạm vi đã phê duyệt nhưng không được tự mở rộng quyền hạn |
Bài học có thể áp dụng lại không nằm ở cách đặt tên theo màu, mà ở việc phân tách nhiệm vụ giữa phát hiện, đánh giá và hành động. Các đội đang thiết kế ranh giới quyền hạn tương tự có thể dùng hướng dẫn về AI agent có kiểm duyệt của con người làm mẫu bổ trợ. Hướng dẫn đó chỉ ra nên đặt cổng kiểm duyệt ở đâu khi agent có thể thay đổi hệ thống bên ngoài.
Red, Blue và Green tạo thành vòng kiểm soát an toàn hơn
Việc tách Red, Blue và Green chỉ giúp kiểm soát tốt hơn khi không agent nào vừa tạo bằng chứng, vừa tự xác nhận ý nghĩa của bằng chứng đó, lại vừa tự ủy quyền thay đổi. Vòng lặp sẽ thất bại khi các quyền hạn đó bị gộp vào cùng một vai trò.
Phân tích của Van Data Team: tách bằng chứng, đánh giá và thực thi
Hình minh họa sau cho thấy không có đường đi thẳng từ phát hiện đến production:
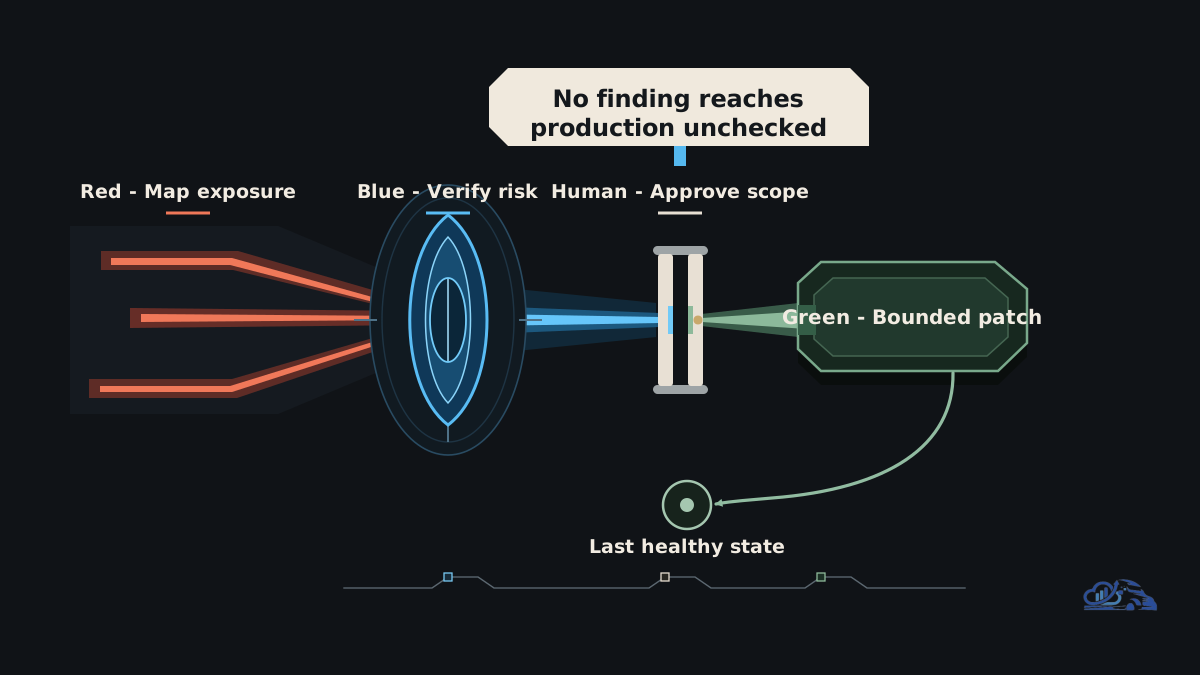
Hình 1. Một vòng lặp bảo mật Agentic AI an toàn tách biệt bằng chứng, đánh giá, ủy quyền và thực thi, đồng thời luôn giữ đường quay về trạng thái ổn định gần nhất.
Hãy coi Red là bên tạo bằng chứng, Blue là ranh giới rủi ro và chính sách, còn Green là bên thực thi có kiểm soát. Một phát hiện của Red không bao giờ được trực tiếp kích hoạt hành động của Green. Blue cần kiểm tra độc lập xem bằng chứng có liên quan, còn mới và nằm trong chính sách hay không.
Một bản bàn giao hữu ích từ Blue gồm bằng chứng nguồn, độ tin cậy, tài sản bị ảnh hưởng, phạm vi đề xuất, người phụ trách tài sản và trạng thái escalation. Nó cũng nên ghi lại những bất đồng đáng kể giữa các agent. Green nên từ chối tác vụ khi bản bàn giao không đầy đủ hoặc xung đột với chính sách.
Hãy xét một phát hiện giả định ở dịch vụ quản lý danh tính. Red lập bản đồ mức độ phơi nhiễm có thể xảy ra, trong khi Blue kiểm tra phiên bản đã triển khai, khả năng truy cập, người phụ trách và độ mới của telemetry. Nếu rủi ro là đáng kể, Green tạo bản vá trên một branch và xác thực trong môi trường riêng. Người phụ trách dịch vụ phê duyệt một đợt rollout giới hạn, còn các tín hiệu health check quyết định thay đổi được mở rộng hay rollback.
Thiết kế này hạn chế các lỗi dây chuyền có tương quan. Agent tự tin tìm ra điểm yếu vẫn có thể hiểu sai ngữ cảnh nghiệp vụ hoặc các phụ thuộc khi triển khai. Bước triage độc lập tạo ra một chốt chặn để bắt lỗi đó trước khi nó chạm tới production.
Quy mô điều phối của MDASH cũng khiến kỷ luật runtime trở thành điều bắt buộc. Chi phí, độ trễ, ngân sách token, observability và đánh giá trở thành những ràng buộc thiết kế hàng đầu. Hãy trace mọi lời gọi công cụ và mọi lần bàn giao, giới hạn retry, xác định cách giải quyết xung đột và đo lường toàn bộ workflow thay vì từng agent riêng lẻ.
Quản trị khả năng tự động khắc phục trước khi cấp quyền production
Các agent có khả năng hành động nên được cấp quyền trên production theo từng giai đoạn, và chỉ được mở rộng quyền sau khi có bằng chứng cho thấy hành vi của chúng nằm trong giới hạn và có thể hoàn tác. Quyền hạn nên được mở rộng chậm hơn so với năng lực kỹ thuật của agent.
Phân tích của Van Data Team: phân loại hành động trước khi cấp quyền
Phân loại từng hành động theo khả năng hoàn tác, các phụ thuộc bị ảnh hưởng, độ nhạy cảm của dữ liệu, đặc quyền cần thiết và phạm vi ảnh hưởng vận hành. Mặc định nên chọn mức quyền ít nguy hiểm nhất mà vẫn tạo ra được bằng chứng hữu ích.
Một lộ trình an toàn đi theo trình tự dưới đây. Mỗi giai đoạn bổ sung bằng chứng trước khi bổ sung quyền hạn.
- Đọc và điều tra trong các tài sản đã phê duyệt
- Đề xuất bản vá trong branch hoặc pull request
- Xác thực thay đổi trong môi trường cô lập
- Triển khai vào một phần nhỏ, có giới hạn của production sau khi có phê duyệt cần thiết
- Chỉ mở rộng khi tín hiệu health check và cổng kiểm thử hồi quy đều đạt
Hãy dùng checklist quản trị và cổng phê duyệt này làm artifact triển khai ban đầu. Điều chỉnh người phụ trách và ngưỡng theo từng dịch vụ đang được bảo vệ.
| Cổng | Mặc định khuyến nghị | Bằng chứng cần có trước hành động | Điều kiện chặn hoặc rollback |
|---|---|---|---|
Danh tính agent | Danh tính workload riêng với đặc quyền tối thiểu và thông tin xác thực ngắn hạn | Tài nguyên, hành động, môi trường, người phụ trách và thời hạn đã được phê duyệt | Từ chối và escalate mọi trường hợp vượt phạm vi |
Tin cậy đầu vào | Chỉ dùng telemetry, code và nguồn tài sản đã được phê duyệt | Độ mới, lineage, người phụ trách và trạng thái SLA | Dừng khi bằng chứng cũ, không đầy đủ hoặc không thể trace |
Tách biệt rủi ro | Bên lập bản đồ rủi ro không được ủy quyền khắc phục | Phân loại độc lập, tài sản bị ảnh hưởng, độ tin cậy và kết quả chính sách | Dừng khi rủi ro chưa được xác minh hoặc các agent bất đồng đáng kể |
| Tạo bản vá | Mặc định dùng branch hoặc pull request | Lý do, diff, kiểm thử, tác động phụ thuộc và bằng chứng nguồn | Từ chối khi kiểm thử hoặc kiểm tra chính sách thất bại |
Xác thực cô lập | Chạy ở môi trường non-production trước khi lên production | Kết quả kiểm thử hồi quy, kiểm tra bảo mật, tín hiệu health check và kiểm thử rollback | Revert và escalate khi có hành vi bất thường |
Phê duyệt production | Con người ký duyệt các thay đổi có phạm vi ảnh hưởng lớn | Mức rủi ro, người chịu trách nhiệm, phạm vi rollout và kế hoạch phục hồi | Chặn khi thiếu phê duyệt hoặc chưa sẵn sàng rollback |
Rollout theo giai đoạn | Phạm vi production nhỏ nhất mà vẫn có ý nghĩa | Baseline, tình trạng canary, tín hiệu lỗi và tiêu chí mở rộng | Rollback khi vượt ngưỡng đã được phê duyệt |
Hồ sơ kiểm toán | Nhật ký chống chỉnh sửa, nằm ngoài quyền ghi của agent | Danh tính, bằng chứng, phiên bản, công cụ, phê duyệt, thay đổi và kết quả | Chặn khi trace không được ghi lại |
Bước phê duyệt của con người nên đặt ở những chỗ mà một sai sót có thể lan rộng hoặc khó phục hồi. Thay đổi danh tính, truy cập dữ liệu nhạy cảm, migration không thể hoàn tác và thay đổi ảnh hưởng nhiều dịch vụ cần được chuyển đến người phụ trách dịch vụ hoặc đội bảo mật chịu trách nhiệm. Tự động hóa trong giới hạn chính sách phù hợp với các hành động có thể hoàn tác, phạm vi hẹp, có giám sát đáng tin cậy và rollback đã được kiểm thử.
Agent không bao giờ được tự mở rộng quyền của mình để hoàn thành tác vụ. Việc quản lý quyền phải đi qua một luồng danh tính và phê duyệt riêng. Điều này ngăn một tác vụ khắc phục bị chặn trở thành lối đi vòng qua cơ chế ủy quyền.
Rollback là một phần của "hợp đồng hành động", không phải bước dọn dẹp sau cùng. Ghi lại baseline trước khi thay đổi, xác định ngưỡng health check, kiểm thử đường revert và triển khai theo giai đoạn. Nếu vượt ngưỡng, hệ thống nên tự động rollback và escalate kèm trace đầy đủ.
Giữ hồ sơ kiểm toán nằm ngoài quyền ghi của agent. Ghi lại danh tính thực hiện, bằng chứng, phiên bản mô hình và chính sách, lời gọi công cụ, thay đổi đề xuất, người phê duyệt, diff kết quả, tín hiệu health check và kết quả rollback. Hồ sơ đó phải hỗ trợ replay và rà soát sau sự cố.
Coi AI agent bảo mật tự động là một danh tính zero trust
AI agent bảo mật tự động là một danh tính workload có quyền theo phạm vi, không phải một "người nhà" đáng tin cậy với quyền truy cập rộng. Quyền truy cập của nó phải có thời hạn, quy được trách nhiệm và dừng lại ở các ranh giới tài nguyên rõ ràng.
Giới hạn danh tính, quyền và thời gian
Cấp cho mỗi vai trò một danh tính riêng. Chỉ cấp quyền trên những tài nguyên, hành động và môi trường được nêu rõ, sau đó cấp thông tin xác thực ngắn hạn cho tác vụ đã được phê duyệt. Tách riêng các quyền đọc code, ghi bản vá, merge, triển khai và quản lý quyền.
Từ chối các yêu cầu nằm ngoài phạm vi đã khai báo và chuyển chúng đi rà soát. Quy tắc này áp dụng dù công cụ được gọi qua function calling native, MCP server, CI runner hay cloud API. Mỗi công cụ là một điểm cấp quyền cần kiểm soát.
Coi chất lượng dữ liệu là một phần của ranh giới bảo mật
Agent có thể đưa ra quyết định sai khi telemetry không đầy đủ, đã cũ hoặc không gắn với người phụ trách. Hãy yêu cầu mọi phát hiện phải đi kèm trạng thái độ mới, lineage nguồn, người phụ trách tài sản và ngữ cảnh service-level agreement.
Một nền tảng kỹ thuật data pipeline trưởng thành rất quan trọng, vì agent không thể suy luận an toàn trên thứ telemetry mà không ai tin tưởng. Workflow nên dừng lại khi tín hiệu cần thiết đến muộn, mâu thuẫn hoặc không thể trace. "Không hành động" là kết quả đúng khi yêu cầu về bằng chứng không được đáp ứng.
Chọn framework không thay thế kiểm soát vận hành
LangGraph, LangChain, CrewAI, function calling native, Model Context Protocol (MCP) và Plan-and-Execute có thể triển khai sự tách biệt vai trò tương tự. Chúng có thể mô hình hóa trạng thái, điều phối lời gọi công cụ và tạm dừng để chờ kiểm duyệt. Nhưng chúng không thay bạn đưa ra chính sách danh tính, thiết kế rollback hay mô hình trách nhiệm.
Tại Van Data Team, chúng tôi coi chi phí trên mỗi workflow hoàn thành, độ trễ đầu cuối, ngân sách token, độ đầy đủ của trace và kết quả đánh giá là tiêu chí nghiệm thu. Dự án alice/ai của chúng tôi, nơi một LangGraph supervisor chuyển từng yêu cầu tới các sub-agent chuyên trách, cho thấy một mẫu điều phối tương tự ở lĩnh vực khác. Bảo mật khiến rủi ro về quyền hạn và phục hồi cao hơn, nhưng các khía cạnh vận hành vẫn như vậy.
Đánh giá khả năng tự động khắc phục vượt ra ngoài điểm benchmark
CyberGym cung cấp bằng chứng về khả năng tạo exploit cho các lỗ hổng đã biết, nhưng không chứng minh được khả năng tự động khắc phục an toàn trên production. Để tin tưởng trên production, cần một bộ kiểm thử hồi quy và quản trị rộng hơn.
Theo SecurityWeek, CyberGym đo liệu mô hình có thể tạo proof-of-concept khai thác hoạt động cho các lỗ hổng phần mềm đã biết hay không. Cấu hình MAI-Cyber-1-Flash cùng GPT-5.4 đạt khoảng 95,95% trên benchmark đó. Cùng bài đưa tin cho biết tiết kiệm chi phí khoảng 50% so với cấu hình MDASH đang có mặt trên thị trường.
Đây là các kết quả hẹp, gắn với từng cấu hình cụ thể. Điểm CyberGym được công bố không đo khả năng triage an toàn, tính đúng đắn của bản vá, chất lượng phê duyệt, mối đe dọa chưa biết hay khả năng phục hồi trên production. Kết quả về chi phí cũng không đảm bảo sẽ đúng với workload, chính sách định tuyến mô hình hay môi trường bảo mật khác.
Bộ kiểm thử hồi quy cho production nên kiểm tra cả chất lượng tác vụ lẫn tính toàn vẹn của cơ chế kiểm soát. Phạm vi nên gồm:
- Chất lượng quyết định: mức độ liên quan của phát hiện, dương tính giả và bất đồng đáng kể giữa agent
- An toàn thay đổi: tính đúng đắn bản vá, tác động phụ thuộc và rủi ro hồi quy
- Quản trị: tuân thủ chính sách, thực thi phê duyệt và các lần thử hành động trái phép
- Phục hồi: rollback thành công, hành vi escalation và khoanh vùng lỗi
- Runtime: lỗi công cụ, lỗi bàn giao, chi phí, độ trễ, mức dùng token và trần retry
- Bằng chứng: độ đầy đủ của trace, độ mới của telemetry, lineage và người phụ trách tài sản
Chạy lại bộ này bất cứ khi nào mô hình, prompt, công cụ, chính sách, quyền, phụ thuộc hoặc dữ liệu nguồn thay đổi. So sánh phiên bản ứng viên với một baseline cố định và chặn triển khai khi các cổng an toàn bị suy giảm. Lưu artifact đánh giá cạnh trace của hành động.
Trong một đợt rollout giả định, agent có thể trước hết sửa một phụ thuộc ở môi trường non-production và vượt qua mọi kiểm thử bắt buộc. Sau đó nó đề xuất một canary có giới hạn thay vì thay đổi toàn bộ fleet. Nếu tín hiệu lỗi hoặc độ trễ xấu đi, nền tảng sẽ revert và escalate. Quyền tự động rộng hơn chỉ đến sau khi bằng chứng được lặp lại nhiều lần, không phải là cấu hình ban đầu.
Với các cơ chế kiểm soát runtime đi kèm, hãy dùng cẩm nang vận hành AI agent và escalation cho con người để xác định người phụ trách, giám sát và bàn giao sự cố. Cẩm nang này bổ trợ cho bộ kiểm thử hồi quy ở trên.
Bài toán khó nhất là hành động có kiểm soát
Project Perception cho thấy rõ bước chuyển từ cảnh báo sang hành động: các agent bảo mật có thể lập bản đồ rủi ro, đánh giá phát hiện và tạo thay đổi khắc phục. Bài học vận hành cho bảo mật Agentic AI là năng lực và quyền hạn phải được thiết kế tách biệt.
Hãy bắt đầu với danh tính riêng biệt, điều tra ở chế độ chỉ đọc, đề xuất bản vá, xác thực trong môi trường cô lập, cổng do con người quyết định, rollout có giới hạn, rollback tự động và nhật ký chống chỉnh sửa. Yêu cầu bằng chứng kiểm thử hồi quy sau mọi thay đổi về mô hình, prompt, công cụ, chính sách, quyền hoặc telemetry. Chỉ giảm mức kiểm duyệt khi hành vi đo lường được cho thấy điều đó là hợp lý.
Van Data Team có thể biến mẫu này thành một workflow rà soát rủi ro có phạm vi rõ ràng. Một buổi rà soát phạm vi security agent có thể cho ra bản đồ tín hiệu và quyền hạn, ma trận phê duyệt, kế hoạch đánh giá và phạm vi triển khai theo giai đoạn. Mục tiêu không phải là tối đa hóa quyền tự động, mà là hành động có kiểm soát mà người phụ trách kỹ thuật và bảo mật có thể quan sát, dừng lại, phục hồi và giải thích.
Nhà sáng lập Van Data Team, trực tiếp xây dựng Vanaxity và điều hành kỹ thuật dữ liệu, AI Agent cho các đội ngũ doanh nghiệp.
Về tác giảCâu hỏi thường gặp
Những câu hỏi người đọc thường đặt ra tiếp theo.
Các câu trả lời ngắn này làm rõ những câu hỏi thực tế thường xuất hiện sau khi đọc bài viết.
Bạn cần một hệ thống tương tự?
Nếu bài viết này phản ánh một quy trình đội ngũ bạn đang vận hành, bước tiếp theo thường là rà soát có phạm vi về hệ thống, ràng buộc và lộ trình triển khai.
Tư vấn
Xác định phạm vi cho quy trình AI tiếp theo.
Chia sẻ hệ thống và điểm nghẽn. Chúng tôi sẽ cùng làm rõ mức độ phù hợp, khoảng trống và bước tiếp theo.