Chi phí năng lượng ẩn của AI agent: Phát hiện 136.5x của KAIST có ý nghĩa gì với MLOps và data pipeline
Phát hiện 136.5x của KAIST nói gì với các đội vận hành production: cách đánh giá mức độ phù hợp của workflow, rủi ro và chi phí năng lượng của AI agent.
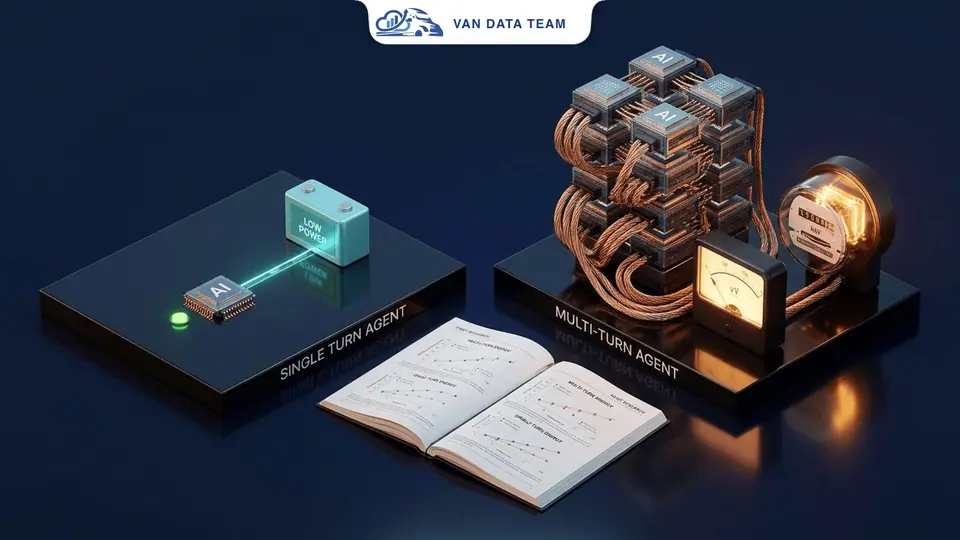
Bài học từ phát hiện 136.5x của KAIST là các đội vận hành production phải đo lường toàn bộ workflow của agent, chứ không chỉ riêng prompt. Phần tốn kém thường nằm ở chuỗi thao tác quanh mô hình: planning, gọi tool, thao tác trình duyệt, retrieval, chạy code, retry, reflection và chuyển cấp cho con người.
Agentic AI trông giống một cuộc hội thoại ở giao diện, nhưng phía sau lại vận hành như một workflow phân tán. Với dịch vụ AI và data engineering, chúng tôi bắt đầu bằng việc xác định agent lấy context từ đâu, được gọi những tool nào, khi nào phải dừng và những gì cần hiển thị trên dashboard trước khi mở rộng quy mô.
Bối cảnh công cụ và độ phù hợp
Hãy so sánh LangGraph, LangChain, CrewAI, native function calling, MCP, Airflow và dbt dựa trên mức độ phù hợp với workflow, khả năng orchestration và kiểm soát runtime. Đừng chọn chỉ vì công cụ đó đang phổ biến.
Ngân sách vận hành
Trước khi rollout lên production, hãy chấm điểm từng phương án theo chi phí trên mỗi output được chấp nhận, độ trễ, ngân sách token, tỷ lệ retry, số phút người duyệt phải bỏ ra, khả năng khôi phục khi lỗi và kết quả đánh giá. Giá token của nhà cung cấp chỉ là điểm khởi đầu.
Điểm chính
- Workflow agent có thể nhân bội mức tiêu thụ năng lượng qua các vòng planning, tool use, quan sát và self-reflection lặp lại.
- Korea Times đưa tin một agent xây trên LLM 70 tỷ tham số tiêu thụ trung bình 348.41 watt-hour cho mỗi truy vấn phức tạp.
- Mirage News cho biết thời gian phản hồi của agent có thể tăng tới 153.7 lần, trong khi GPU có thể nằm không tới 54.5% tổng thời gian thực thi để chờ tool bên ngoài.
- Theo dõi năng lượng trên mỗi workflow, mức sử dụng GPU, số lần retry, thời gian chờ tool và tỷ lệ chuyển cấp như các tín hiệu production, song song với độ trễ, độ chính xác và chi phí.
- Dùng pipeline deterministic, retrieval, lớp context cache hoặc hàng đợi có người duyệt khi chúng đủ sức thay thế agent tự chủ.
| Câu hỏi production | Chatbot tiêu chuẩn | Workflow agentic | | -------------------- | --------------------- | ------------------------------------------------------------------------------------------- | | Đơn vị công việc chính | Prompt và câu trả lời | Planning, tool, quan sát, retry và review | | Yếu tố chi phí chính | Model inference | Khuếch đại số lần gọi mô hình và thời gian chờ tool | | Tín hiệu năng lượng | Năng lượng mỗi câu trả lời | Năng lượng mỗi workflow hoàn tất | | Hạ tầng cần quan tâm | Hiệu quả serving | Serving, orchestration, độ trễ tool, GPU nhàn rỗi và thiết kế hàng đợi | | Cảnh báo KAIST | Mức cơ sở để so sánh | Tới 136.5x ở workflow tự chủ dùng nhiều tool |
KAIST thực sự phát hiện gì
KAIST cho thấy các agent dùng nhiều tool biến một yêu cầu của người dùng thành một chuỗi các lần gọi mô hình, gọi tool, chờ đợi, retry và reflection. Mirage News mô tả đây là một đánh giá định lượng về điện năng và chi phí để hiện thực hóa trí tuệ agentic, chứ không chỉ là việc sinh câu trả lời.
Như Digital Trends lưu ý, kết quả 136.5x nên được xem là cảnh báo ở mức cận trên cho các workflow phức tạp, không phải chi phí mặc định của mọi agent. Câu hỏi cần trả lời là workflow đó tạo ra bao nhiêu lần gọi mô hình, bao nhiêu lần chờ tool, retry và bước kiểm tra (validation).
Vì sao MLOps cần Energy SLO
Trace trên production cần thể hiện số lần gọi mô hình theo từng bước, các lần gọi tool và kết quả, các lần retrieval cùng cache hit, lý do retry, thời gian chờ tool, thời gian GPU nhàn rỗi (nếu đo được), độ trễ, chi phí ước tính, kết quả review và việc tác vụ thành công hay thất bại. Một agent kiểm tra chất lượng dữ liệu được vận hành tốt sẽ đối chiếu các dấu hiệu lỗi đã biết và lấy context đã cache của lần chạy trước, rồi mới tính đến việc đọc log tràn lan hoặc tự phản tư nhiều vòng.
Thay đổi trong thiết kế data pipeline
Agent nên được xem là một workload của pipeline: nó di chuyển context, gọi tool, chờ các hệ thống khác và tạo ra output cần được kiểm tra. Hãy chạy theo batch khi context có thể chuẩn bị trước, theo kiểu event-driven khi sự kiện gấp và có giá trị cao, hoặc qua hàng đợi có người duyệt với các thay đổi về chính sách, tài chính, xóa dữ liệu và các quyết định ảnh hưởng tới khách hàng.
Bài viết về AI agent với kiểm duyệt của con người giải thích vì sao các checkpoint duyệt giúp ngăn agent có độ tin cậy thấp tiếp tục đốt thêm compute. Hướng dẫn chọn batch hay streaming giúp bạn chọn cách đưa context mới tới agent đúng lúc.
Khung vận hành agent chi phí thấp
Đo trước khi tối ưu
Dashboard cần cho thấy workflow nghiệp vụ nào đã tiêu tốn compute và kết quả có xứng đáng với chi phí đó không, chứ không chỉ có các biểu đồ ở cấp mô hình.
Định tuyến theo độ phức tạp của tác vụ
| Trường hợp dùng | Mặc định tốt hơn | Lý do | | ------------------------------- | ---------------------------------- | ----------------------------------------- | | Tóm tắt metric lặp lại | Batch pipeline kèm phần diễn giải đã cache | Cùng một context được dùng lại nhiều lần | | Câu hỏi hỗ trợ đã biết | Retrieval | Câu trả lời đã có trong kho tri thức được duyệt | | Điều tra sự cố pipeline | Agent có tool budget và escalation | Cần thu thập bằng chứng | | Hành động rủi ro với khách hàng | Agent có người duyệt | Quyết định cuối cùng cần người chịu trách nhiệm | | Tìm hiểu từ các nguồn chưa biết | Agent có giới hạn chặt về nguồn và vòng lặp | Tự chủ có ích, nhưng việc duyệt web dễ vượt tầm kiểm soát |
Giới hạn vòng lặp agent
Đặt giới hạn cho số bước planning, thao tác trình duyệt, lần chạy code, lần retry tool và vòng self-reflection. Nếu agent không đạt đủ độ tin cậy trong ngân sách cho phép thì chuyển cấp cho con người. Một agent chạy mất kiểm soát hiếm khi chỉ tốn kém; nhiều khả năng nó đang bị rối.
Tối ưu truy cập dữ liệu
Ưu tiên dữ liệu có cấu trúc, context chuẩn bị sẵn, cache kết quả retrieval, API phạm vi hẹp và gom batch các lần gọi tool ưu tiên thấp. Đưa công việc vào hàng đợi để accelerator dành thời gian phục vụ inference thay vì chờ các hệ thống bên ngoài. Kỷ luật dùng để tối ưu chi phí hạ tầng data stack cũng áp dụng được ở đây.
Mẫu runbook thực tế
select
  workflow_id,
  count(*) as checked_records,
  sum(case when validation_status = 'failed' then 1 else 0 end) as failed_records
from the_hidden_energy_cost_of_ai_agents_what_kaist_s_136_5x_validation_events
group by workflow_id;
Runbook cần nêu rõ ngân sách, trace, quy tắc định tuyến, review gate và cách khôi phục. Nếu đội ngũ không chỉ ra được phương án fallback, cách người duyệt ra quyết định, lý do retry hoặc nơi lưu audit log, agent đó chưa sẵn sàng cho production.
Kiểu lỗi thường gặp
Những sai lầm hay gặp: xem 136.5x là mức trung bình chung, chỉ đo token, để agent duyệt web trong khi đã có dữ liệu có cấu trúc, bỏ qua review gate, hoặc tách rời hóa đơn cloud khỏi trace của agent. Hãy gắn chi phí với từng workflow để cả đội kỹ thuật lẫn tài chính cùng thấy điều gì đã thay đổi.
Kết luận
Suy cho cùng, phát hiện 136.5x của KAIST là một bài học về kiến trúc workflow: rủi ro production lớn nhất nằm ở chuỗi planning, tool use, chờ đợi, retry và reflection bao quanh mô hình. AI agent vẫn có giá trị khi quan sát được, có giới hạn và được định tuyến đúng. Hãy đo toàn bộ lượt chạy, giới hạn vòng lặp, dùng hệ thống deterministic khi phù hợp, tính trước context và đặt review gate ở những nơi mà rủi ro đòi hỏi phải có người chịu trách nhiệm.
AI Model Brief
Các model AI đáng chú ý, mỗi tuần một lần
Model nào vừa ra mắt, điểm trên các benchmark độc lập, giá mỗi triệu token và model nào đã ngừng hỗ trợ, lấy từ dữ liệu của trang benchmark AI model. Bản tin viết bằng tiếng Anh.
Chúng tôi chỉ dùng địa chỉ của bạn để gửi bản tin. Xem chính sách quyền riêng tư.
Xem bản tin tuần này
Nhà sáng lập Van Data Team, trực tiếp xây dựng Vanaxity và điều hành kỹ thuật dữ liệu, AI Agent cho các đội ngũ doanh nghiệp.
Về tác giảCâu hỏi thường gặp
Những câu hỏi người đọc thường đặt ra tiếp theo.
Các câu trả lời ngắn này làm rõ những câu hỏi thực tế thường xuất hiện sau khi đọc bài viết.
Bạn cần một hệ thống tương tự?
Nếu bài viết này phản ánh một quy trình đội ngũ bạn đang vận hành, bước tiếp theo thường là rà soát có phạm vi về hệ thống, ràng buộc và lộ trình triển khai.
Tư vấn
Xác định phạm vi cho quy trình AI tiếp theo.
Chia sẻ hệ thống và điểm nghẽn. Chúng tôi sẽ cùng làm rõ mức độ phù hợp, khoảng trống và bước tiếp theo.